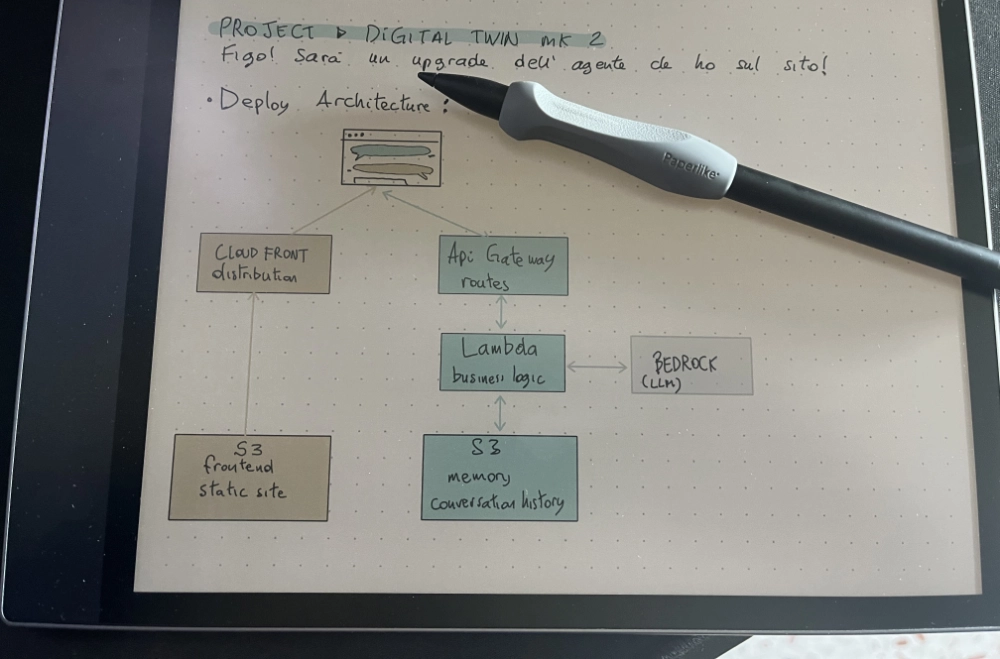
Immagina di iniziare lunedì con solo un quaderno digitale e un laptop. Entro venerdì, hai un sistema AI completamente automatizzato, pronto per la produzione e in esecuzione su AWS, con infrastructure as code, supporto multi-ambiente.
Come qualcuno che esplora l'infrastruttura cloud, volevo capire cosa serve davvero per portare un sistema AI in produzione — non la versione teorica, ma le decisioni reali, i tradeoff, e i principi che emergono quando costruisci qualcosa di reale.
E la parte interessante? Non riguarda davvero il codice. Riguarda le decisioni architetturali, l'evoluzione dell'infrastruttura, e i principi che contano quando costruisci sistemi che funzionano su larga scala.
Questo articolo percorre quel viaggio, spiegando non il "come" ma il "perché"—perché abbiamo preso ogni decisione, quali problemi abbiamo risolto, e quali principi emergono quando effettivamente costruisci qualcosa di reale.
DAY 1: Il "Monolite Locale" — Perché Iniziare Semplice Conta
Cosa abbiamo costruito: Un chatbot che ricorda le conversazioni, in esecuzione sul tuo laptop.
Perché funziona:
Tutto è locale: frontend (Next.js), backend (FastAPI), storage (file JSON)
Zero complessità cloud
Loop di feedback istantaneo
Insight: prima di scalare qualsiasi cosa, devi capire davvero cosa stai costruendo. Il Giorno 1 non riguarda la velocità o l'efficienza. Riguarda la chiarezza. Scopri:
Come funziona la tua memoria delle conversazioni
Come il frontend comunica con il backend
Come si sente l'esperienza utente effettiva
Principio introdotto: La Legge dell'Ottimizzazione Prematura. Non ottimizzare quello che non capisci ancora.
DAY 2: Il "Lift and Shift" — Portare il Sistema Locale al Cloud ☁️
Cosa è cambiato: Abbiamo spostato tutto su AWS.
La decisione: Dove dovrebbe vivere ogni pezzo?
Frontend → S3 bucket (file statici)
Backend → Lambda (serverless compute)
Memory → S3 bucket (storage persistente)
Esperienza utente → CloudFront (CDN globale)
Gestione API → API Gateway
Perché queste scelte?
Lambda over EC2: Potresti affittare un server ed eseguire lì il backend. Ma perché dovresti farlo? Lambda significa:
Nessun server da gestire
Paghi solo per il tempo di esecuzione effettivo
Scalabilità automatica (gratis)
Meno sovraccarico operativo
S3 per lo storage: I tuoi file JSON sono ora file cloud. S3 è:
Durevole (AWS non perderà i tuoi dati)
Economico (pochi centesimi al mese)
Accessibile da ovunque
CloudFront come porta d'ingresso: Invece di far scaricare agli utenti da un singolo server in Irlanda, CloudFront copia i tuoi file statici su server in tutto il mondo. Gli utenti scaricano dai server più vicini = caricamento più veloce.
L'insight chiave: Ogni servizio fa UNA cosa bene. Il tuo compito è collegarli correttamente.
Nuova architettura:
Principio introdotto: La Separazione dei Compiti. Ogni pezzo ha una responsabilità. I cambiamenti in un'area non si ripetono ovunque.
DAY 3: Lo "Scambio di Servizio" — Scegliere il Motore AI Giusto
Cosa è cambiato: Abbiamo sostituito OpenAI con AWS Bedrock.
Il punto di decisione: Hai un sistema funzionante. Perché cambiarlo?
Perché i tradeoff sono cambiati:
Costo: Bedrock è più economico
Latenza: Bedrock è più veloce
Residenza dei dati: I tuoi dati rimangono in AWS (non inviati a OpenAI)
Ecosistema: Tutto è AWS nativo (monitoraggio, integrazione, auditing più facili)
Il Giorno 3 ti insegna che le scelte infrastrutturali non riguardano cosa è meglio—riguardano cosa è meglio per LA TUA situazione.
OpenAI è fantastico. Ma per un sistema di produzione dove controlli l'infrastruttura, hai tutto in un cloud, e vuoi migliore efficienza di costo? Bedrock vince.
E proveremo i foundational models di AWS, la famiglia NOVA:
Nova Micro: Veloce ed economico (sviluppo)
Nova Lite: Buon equilibrio (produzione)
Nova Pro: Migliore qualità (costoso)
Questo è il tuo primo incontro con i tradeoff specifici dell'ambiente. Lo sviluppo può essere veloce ed economico. La produzione ha bisogno di affidabilità e qualità. Stesso sistema, configurazioni diverse.
Principio introdotto: Scegliere lo Strumento Giusto. La soluzione migliore non è universale. Il contesto importa.
DAY 4: La "Codificazione" — Perché l'Infrastruttura Merita il Controllo di Versione
Cosa è cambiato: Abbiamo smesso di cliccare(e impazzire) intorno alla Console AWS. Tutto è diventato codice. 🤯🚀
Capire i Modelli di Servizio: Da PaaS a IaaS
cosa stiamo effettivamente costruendo:
Durante questo viaggio, abbiamo usato tre tipi di servizi:
SaaS (Software as a Service)
Quello che ottieni: Software che usi via internet
Quello che controlli: I tuoi dati e configurazione
Quello che AWS controlla: Tutto il resto (server, aggiornamenti, scaling)
Esempi: OpenAI (Giorno 1-2), Bedrock (Giorno 3) | Modello di costo: Paghi per uso
IaaS (Infrastructure as a Service)
Quello che ottieni: Potenza di calcolo grezza, storage, networking
Quello che controlli: Il tuo codice, configurazione e infrastruttura
Modello di costo: Paghi per le risorse che esegui il provisioning
PaaS (Platform as a Service)
Quello che ottieni: Piattaforma pre-costruita per deployare codice
Quello che controlli: Il tuo codice
Quello che la piattaforma controlla: Tutto il resto
Esempi: Heroku, Vercel, Railway
Modello di costo: Di solito per applicazione o per deployment
Una nota su PaaS: L'evoluzione dalla Settimana 1
Nella Settimana 1 (la settimana precedente del corso), abbiamo usato Vercel—un classico PaaS. Fai push del codice → Vercel gestisce tutto. Perfetto se vuoi che l'infrastruttura scompaia.
Nella Settimana 2, abbiamo fatto una scelta diversa: S3 + CloudFront (IaaS) invece di Vercel (PaaS).
Il tradeoff: La complessità è il prezzo della comprensione. Più cose impari a gestire, più chiaro diventa il sistema.
Perché Terraform Cambia Tutto
Il problema che stiamo risolvendo:
Hai costruito infrastruttura manualmente:
Cliccato i pulsanti su AWS
Creato risorse una per una
Fatto piccoli aggiustamenti qua e là
Qualcuno ti chiede: "Cosa abbiamo creato esattamente?"
Risposta: "Um... non sono sicuro. Fammi controllare la Console AWS."
Ma questo approccio è fragile. Se qualcuno elimina il bucket S3 sbagliato, come recuperi? Lo ricostruisci manualmente, il che richiede ore.
Entra: Infrastructure as Code (IaC) e Terraform
Infrastructure as Code è un'idea semplice: invece di cliccare intorno a una console, scrivi codice che descrive l'infrastruttura che vuoi.
Terraform è uno strumento che ti permette di farlo. È open source, funziona con AWS (e altri cloud), ed è diventato lo standard dell'industria.
Ecco cosa mi ha sorpreso di più: Terraform sembra come il controllo di versione per il tuo cloud. Proprio come `git diff` mostra quale codice è cambiato, `terraform plan` mostra quale infrastruttura cambierà. Il tuo cloud diventa qualcosa che puoi revisionare, committare e fare rollback.
Scrivi un file (in un linguaggio chiamato HCL) che dice:
"I want:
- Two S3 buckets (frontend and memory)
- One Lambda function
- One API Gateway
- One CloudFront distribution
- IAM roles with specific permissions"Code language:PHP(php)
Poi esegui: `terraform apply`
E AWS crea esattamente ciò che hai definito. Ogni. Singola. Volta. Identicamente.
La parte magica: Se lo esegui di nuovo, Terraform controlla "è già qui questa infrastruttura?" Se lo è, non fa nulla. Se qualcosa è cambiato, aggiorna solo quello che è diverso.
Questa è infrastruttura dichiarativa: Dichiara quello che vuoi, Terraform scopre come farlo accadere.
Perché questo importa:
Riproducibilità: Esegui il comando di nuovo, ottieni la stessa infrastruttura
Controllo di versione: La tua infrastruttura vive in Git, puoi vedere la storia
Documentazione: Il codice È la documentazione
Sicurezza: `terraform plan` ti mostra cosa cambierà prima che lo faccia
La Potenza di .tfvars: Un Codice, Più Ambienti
Stesso codice per dev e prod? Come?
Con file di configurazione dell'ambiente (`.tfvars`):
Stesso codice Terraform, valori diversi, risultati diversi.
Questo è profondo perché significa:
Il tuo ambiente dev è veramente usa e getta (elimina e ricrea in qualsiasi momento)
Il tuo ambiente prod è configurato per affidabilità e sicurezza
Ma sono entrambi costruiti dallo stesso template
Principio introdotto: Sicurezza con Privilegi Minimi Dai a ogni sistema solo i permessi che assolutamente ha bisogno. Niente di più.
Questo è uno dei concetti più importanti della sicurezza infrastrutturale.
Esempio:
Development Lambda: "Puoi fare QUALSIASI COSA con i servizi AWS"
Production Lambda: "Puoi leggere/scrivere dal bucket X e invocare il modello Y. Ecco tutto."
Perché? Perché se il tuo Lambda di produzione viene hackerato o ha un bug, l'attaccante non può:
Eliminare database
Accedere ad altri bucket S3
Modificare policy IAM
Escalare privilegi
Può solo fare ciò che il Lambda deve legittimamente fare.
Questo sembra ovvio in retrospettiva, ma è profondo nella pratica. Molti sistemi falliscono gli audit di sicurezza perché danno permessi eccessivamente ampi "nel caso".
Principio introdotto: Automazione Su Processo Manuale
Crei gli script `deploy.sh` e `destroy.sh` che automatizzano tutto:
Costruisci il package Lambda
Inizializza Terraform
Applica l'infrastruttura
Deploya il frontend
Sincronizza file
Un comando. Tutto accade. Consistente, ripetibile, documentabile.
Se puoi eliminare tutto e ricrearlo con un comando, hai vinto. Non hai paura di sperimentare.
LA VISIBILITÀ BATTE L'INVISIBILITÀ
Il codice Terraform mostra cosa esiste
La storia Git mostra perché le decisioni sono state prese
I log mostrano cosa sta succedendo adesso
La documentazione spiega il viaggio
Nessuna supposizione nascosta. Nessuno "solo tu sai come"
Conclusione: Dal Locale al Globale in Una Settimana
Quello che abbiamo costruito non è rivoluzionario in termini di tecnologia. Questi servizi esistono. Ma il viaggio è stato fantastico.🚀
I sistemi di produzione non sono magici. Sono intenzionali, documentati e costruiti strato dopo strato.
Dalla Demo al Mondo Reale
Questo Digital Twin è intenzionalmente un foglio bianco—costruito per capire l'architettura passo dopo passo.
Ma il valore reale non è in questo progetto. È nell'applicare questi principi a sistemi effettivi e complessi.
Ho un sistema di produzione nel mondo selvaggio: website-agent. E lo trovi live proprio su questo sito! È più sofisticato. Ed è stato costruito nel modo vecchio—infrastruttura manuale, deployment manuale, conoscenza implicita su cosa sta girando dove.
Se vuoi scoprire di più sul mio website agent, leggi qui
Nei prossimi mesi trasformerò website-agent usando esattamente quello che ho imparato questa settimana:
Infrastructure as Code: Ogni risorsa AWS definita in Terraform (non più click sulla Console AWS)
Multi-ambiente: Dev è economico e usa e getta. Prod è sicuro e affidabile. Stesso codice, configurazioni diverse.
Privilegi Minimi: Non "dagli tutti i permessi, nel caso". Invece: "Cosa ha effettivamente bisogno di fare questo servizio? Solo quello."
Deployment Automatici: Fai push del codice → GitHub Actions esegue → l'infrastruttura si aggiorna. Nessun intervento umano nel percorso critico.
Visibilità: Tutto nel controllo di versione. Puoi vedere la storia. Puoi capire le decisioni.
Il Digital Twin è stato il blueprint. Website-agent è dove testerò se il blueprint effettivamente funziona su sistemi reali.
Riconoscimenti
Questo progetto è stato realizzato seguendo il corso "Generative and Agentic AI in Production" di Ed Donner, disponibile su Udemy.
Se sei interessato a questo viaggio, consiglio molto il corso!
Da quando uso Claude Code, il mio modo di sviluppare è cambiato. Non tanto perché scrive codice al posto mio, ma perché è diventato il mio pair programming partner: qualcuno con cui discutere scelte architetturali, validare pattern, ragionare su trade-off. Quando lavoro da sola, è facile restare incastrata nelle mie assunzioni. Avere Claude che fa […]
Oggi è il secondo giorno dal mio rientro. La mia testa continua a correre, a pensare, a tentare di mettere a terra tutte le idee e gli stimoli accumulati in questi giorni. Dall'altro lato continua a rivivere momenti, sorrisi, difficoltà affrontate, sensazioni scaturite dal parlare con altre persone, dal trovarsi davanti degli occhi che si […]